Vorhersagen / Prognosen von Zeitreihen
Handling von Prognose - Zeitreihendaten
Zeitreihenprognosen haben inhärent zwei zeitliche Dimensionen:
- den Erstellungszeitpunkt der Prognose bzw. welche vorhandenen Daten in die Prognose eingehen konnten (knowledge cutoff). Genau genommen müssen Erstellungszeitpunkt und knowledge cutoff nicht übereinstimmen, in den allermeisten Fällen kann das aber angenommen werden.
- den Zielzeitpunkt, also für welchen Zeitpunkt die Prognose gemacht wird.
Wenn man beispielsweise um 12:00 Uhr anhand der aktuellen und vergangenen Wetterdaten eine Prognose für die Temperatur um 14:00 Uhr macht, dann ist 12:00 Uhr der Erstellungszeitpunkt (und der knowledge cutoff) und 14:00 Uhr ist der Zielzeitpunkt
Häufig wird anstelle des absoluten Zielzeitpunkts auch die Differenz zum Erstellungszeitpunkt angegeben. Im Beispiel würde man von einer 2 Stundenprognose sprechen die am Zeitpunkt 12:00 Uhr gemacht wurde. Beide Darstellungen sind natürlich äquivalent und lassen sich ineinander umrechnen.
Kommen durch das Verstreichen von Zeit neue Daten hinzu und rückt man näher an den Zielzeitpunkt kann typischerweise eine genauere Prognose erstellt werden. Deshalb werden Prognosen in vielen Fällen regelmäßig aktualisiert. So ist im Beispiel um 13:00 Uhr wahrscheinlich eine bessere Temperaturprognose für den Zielzeitpunkt 14:00 Uhr erstellbar.
Zu einem gegebenem Betrachtungszeitpunkt interessiert daher den Nutzer i.d.R. die aktuellste Prognose für jeden Zielzeitpunkt.
Die hetida Plattform hat für eingehende Daten ein Handling für vorhandene Daten am gleichen Zeitstempel: Kommt ein neuer Wert für einen Zeitpunkt so wird der neue Wert gespeichert und bei Abfragen wird im Standardfall der neueste Wert für jeden Zeitpunkt geliefert. Das erreicht die Plattform indem sie für jeden Datenpunkt auch den Erstellungszeitpunkt bzw. bei Eingangsdaten den Eingangszeitpunkt speichert. Der alte Wert für diesen Zielzeitpunkt ist somit weiterhin vorhanden und wird nicht gelöscht. Er kann über die Zeitreisefunktion eingesehen werden, indem man den Betrachtungszeitpunkt entsprechend wählt.
Speichert man somit also Prognosedaten einfach am Zielzeitpunkt, so sieht man im Standardfall immer die aktuellste verfügbare Prognose für jeden Zielzeitpunkt. Wählt man einen älteren Betrachtungszeitpunkt so sieht man eben die zu diesem Zeitpunkt vorhandene aktuellste Prognose.
Dies gilt wie bereits gesagt sowohl für Eingangsdaten-Signale als auch für persistente virtuelle Signale. D.h dieser Mechanismus führt auch für innerhalb der Plattform via Workflows regelmäßig berechnete virtuelle Signale die gewünschte Sicht auf die für den Betrachtungszeitpunkt aktuellsten Prognosen.
In Zukunft wird es in der Analytik auch die Möglichkeit geben alle historischen Daten für alle Betrachtungszeiträume abzurufen, um z.B. eine kontinuierlich laufende Prognose nachträglich analytisch auswerten zu können
Berechnung Erstellen von Prognosen in der hetida Plattform
Neben von außen als Eingangsdaten eingehenden Prognosen (z.B. auch von Drittanbietern) ist natürlich das Erstellen von eigenen Prognosen in der hetida Plattform eine wesentliche Quelle für Prognosen.
Typischerweise wird hierfür ein persistierendes virtuelles Signal angelegt, dem ein passender hetida designer Workflow zu Grunde liegt. Über den hetida designer stehen Prognosefunktionen aus dem Python Data Science Ökosystem zur Verfügung und können passend und zielgenau verschaltet, angepasst und eingesetzt werden.
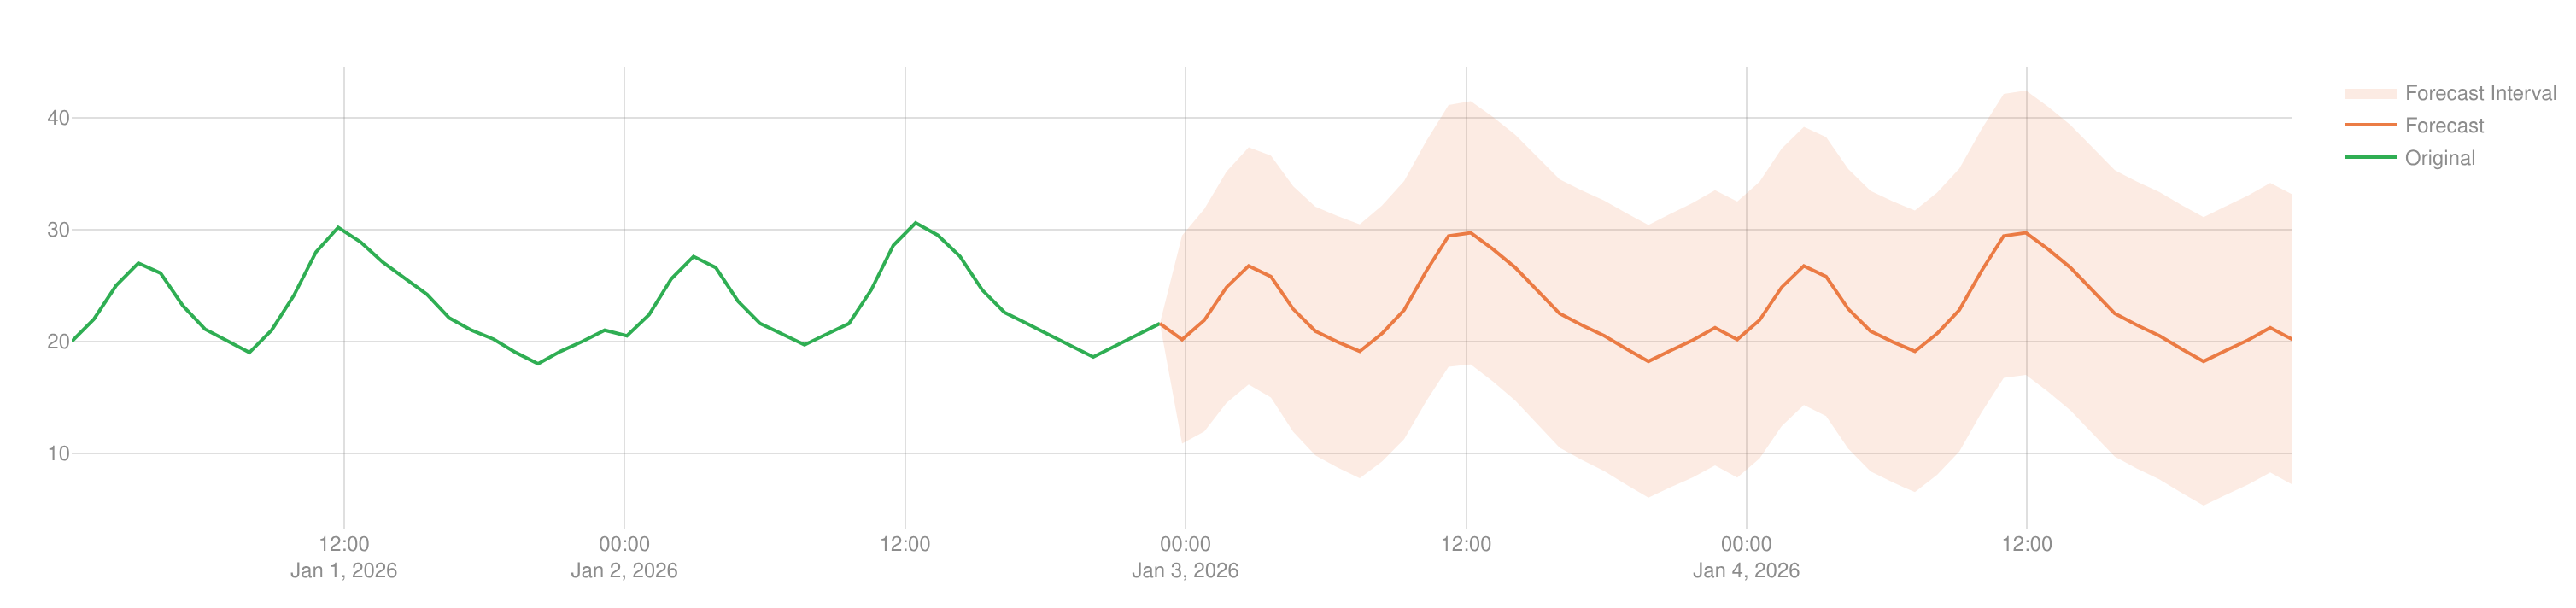
Häufig ist sogar keine Persistierung notwendig, solange die Prognoseberechnung selbst schnell genug ist. Eine solche Prognoseberechnung, die direkt eine Prognose basierend auf nur der Zeitreihe selbst liefert stellt beispielsweise der Workflow "Simple Time Series Forecast" zur Verfügung. Er generiert als Ergebnis direkt eine Visualisierung die auch die Anzeige von Konfidenzbereichen beinhalten kann. Er kann einfach als Workflow-Konfiguration konfiguriert werden und somit direkt in Dashboards eingebettet werden: